Jiayuan Zhou
LLM 修复智能体的经验复用

STAIR

Reusing Past Repairs Through Hierarchical Trajectory Abstraction for Coding Agents

修复智能体已经能够解决代码仓库级的 issue,但许多智能体仍把每个 issue 当作孤立的任务来处理。STAIR 复用以往成功修复中的做法:它把每条修复轨迹按阶段切分,把其中的每个过程保留为多个粒度的修复配方(repair recipe),从针对特定仓库的具体步骤到宽泛的策略;再把适用于新 issue 的配方改写成每个修复阶段的计划。

Yisen Xu1, Jiayuan Zhou2, Ruiqi Pan3, Tse-Hsun (Peter) Chen1

1SPEAR Lab, Concordia University, Montreal, Canada · 2Waterloo Research Center, Huawei, Canada · 3Huawei Technologies Co., Ltd.

论文 · arXiv BibTeX 代码 · 待定
核心观点既不过于具体,也不过于笼统:保留每一种粒度,按阶段选择。经验复用的收益来自两点:把过去一次修复中的每个过程保留为多个详略层次,并把为新 issue 选出的过程转化为针对该 issue 的具体动作。
01 · 问题

复用过去的修复,该取哪个层次?

有经验的开发者会复用以往有效的做法:定位策略、编辑步骤、验证步骤。

这些知识存在于不同的粒度上。具体的过程,例如检查某个配置文件,可以直接照做,但可能只适用于密切相关的 issue。更宽泛的策略,例如从故障点沿数据流反向追踪,迁移范围更广,却较少告诉智能体下一步该做什么。已有的复用历史修复的智能体(Lingxi、SWE-Exp、ExpeRepair)在提取知识时就固定了单元和粒度:整次修复、阶段级经验,或者一个示范加上抽象洞见。它们都没有把一次过去的修复拆成各自独立的过程,并把每个过程保留为多个详略层次。

过于具体

按原样复用具体的修复

具体步骤可以直接照做,但可能只适用于密切相关的 issue。新 issue 也许需要过去修复中的定位策略,却不需要其中针对该仓库的编辑;原始轨迹还夹杂着工具输出、失败的尝试和重复的动作。

具体步骤 · 论文图 1 中的示例
  1. Remove the “Add” button
  2. User still added items
  3. Checked why it still worked
  4. Found a hidden shortcut
过于笼统

只复用一条抽象洞见

宽泛的策略能迁移到更多 issue,但可能省略了让策略奏效的动作,包括密切相关的 issue 所需要的步骤。它对智能体下一步该做什么的指导也更少。

高层原则 · 同一示例

Always enforce intent at every system layer, not just at the visible entry point.

核心问题智能体如何识别过去一次修复中可复用的过程,并把每个过程表示为未来修复所需要的详略层次?STAIR 的回答是:保留每一个层次,让新 issue 的每个修复阶段取用适用的配方。
02 · 方法

保留每一种粒度,按阶段选择。

STAIR 由三个环节组成。环节 1 离线运行,在任何目标修复开始之前只执行一次。环节 2 和 3 针对每个新 issue 运行,并分别作用于三个修复阶段:定位、规划、执行与验证。修复配方(repair recipe)是从过去修复中提炼出的可复用过程或策略;修复计划(repair plan)则把选中的配方落实到目标 issue 上。

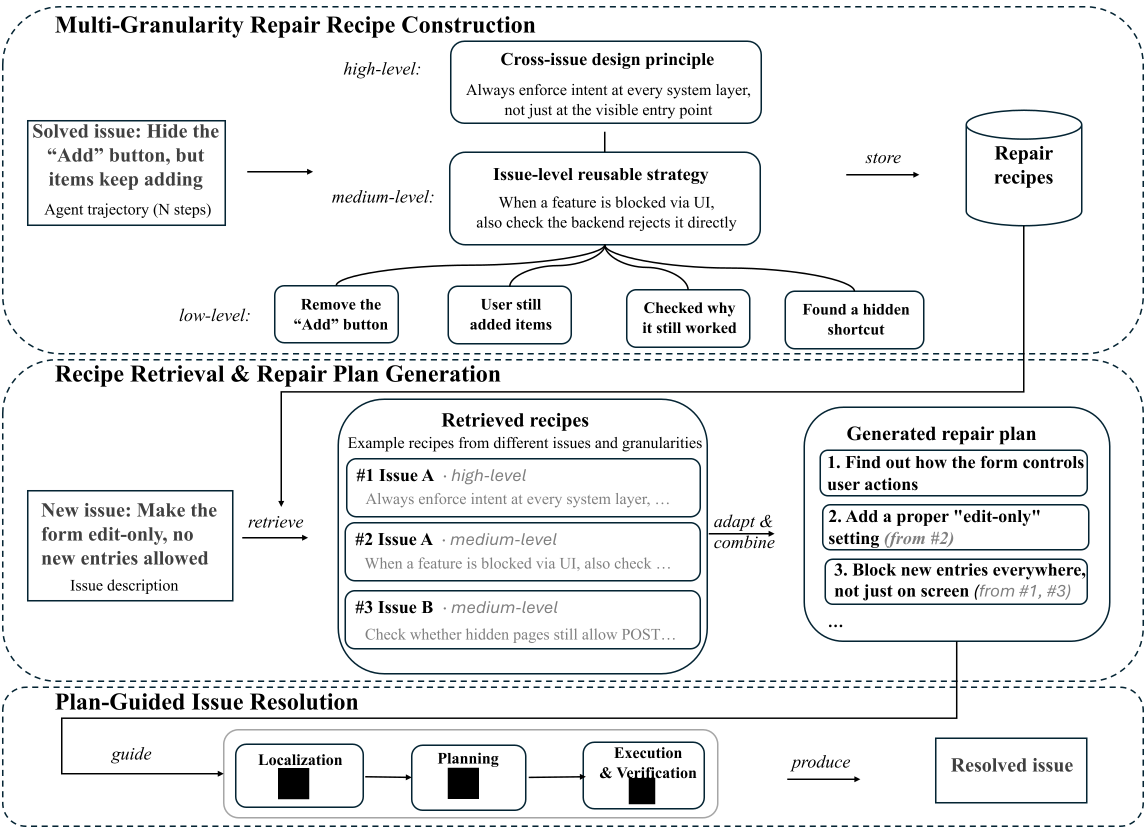
怎么读自上而下,顺着箭头看。环节 1 把一个已解决 issue 的轨迹转化为低、中、高三层配方,并全部存储。环节 2 为新 issue 检索来自不同历史 issue、不同粒度的配方,并组合成一份计划;计划的每一步都注明来自哪些配方。环节 3 把计划交给修复智能体。

图中要点没有哪个层次能取代其他层次:计划的第二步来自一个中层配方,第三步来自两个不同 issue 的一个高层配方和一个中层配方。图为论文图 1;配方构建、检索和计划生成都按修复阶段分别进行。

1环节 1 · 离线构建修复配方

先按阶段切分,再逐层抽象。

STAIR 在同一仓库较早的 issue 上运行 Lingxi 的修复脚手架(关闭其知识复用机制),保留成功修复的轨迹。每条轨迹按修复阶段切成三个有序片段:τ(u) = ⟨τloc, τplan, τexec⟩。在一个片段内,LLM 算子 Gℓ 把服务于同一修复目的的连续步骤分为一组,算子 Aℓ 再把每组抽象为一条配方。随后对配方再次分组和抽象,直到最多剩下 K = 2 条。每一层都会保留。

一条成功的轨迹
τloc定位τplan规划τexec执行与验证

配方按片段分别构建,之后也按片段分别检索。下方展示其中一个片段,对应论文中的示例。

高层通用的问题求解原则
跨 issue 的设计原则Always enforce intent at every system layer, not just at the visible entry point
中层与具体项目无关的排查策略
issue 级可复用策略When a feature is blocked via UI, also check the backend rejects it directly
低层立足于项目制品的具体子目标
Remove the “Add” buttonUser still added itemsChecked why it still workedFound a hidden shortcut
来源智能体轨迹,N 步
Solved issue: Hide the “Add” button, but items keep adding
意图该过程要达成的目标
关键动作执行该过程所用的动作
适用条件在什么条件下有用
陷阱修复中遇到的常见陷阱

每一层的每条配方都有这些字段,只是具体程度不同:低层配方可以写出具体的 API,高层配方必须完全通用。配方用 GPT-5 一次性构建,来自 479 条历史轨迹(每条约 $0.44,共约 $211),所有配置共用。

分组算子 Gℓ · 图 2
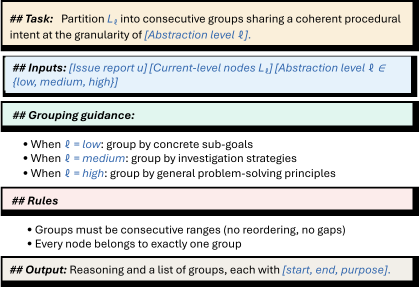
分组算子的简化 prompt。任务:在给定的抽象层次上,把当前层划分为若干连续分组,每组具有一致的过程意图。输入:issue 报告、当前层节点、抽象层次(低、中、高)。指导:低层按具体子目标分组,中层按排查策略分组,高层按通用的问题求解原则分组。规则:分组必须是连续区间,不能重排或留空,每个节点恰好属于一个分组。输出:推理过程和分组列表,每组给出起点、终点和目的。
怎么读:所有层次共用一个模板,只有指导语随 ℓ 变化。分组必须连续并覆盖每个节点,因此保留了阶段内的顺序。
抽象算子 Aℓ · 图 3
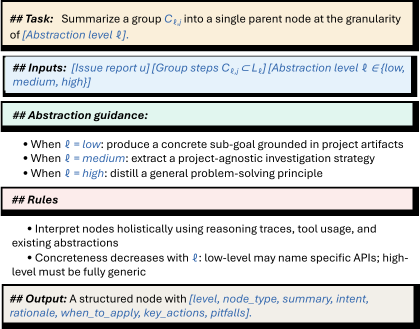
抽象算子的简化 prompt。任务:在给定的抽象层次上,把一个分组概括为一个父节点。输入:issue 报告、组内步骤、抽象层次。指导:低层产出立足于项目制品的具体子目标,中层提炼与项目无关的排查策略,高层提炼通用的问题求解原则。规则:结合推理轨迹、工具使用和已有抽象整体理解节点;具体程度随层次升高而降低。输出:结构化节点,包含层次、节点类型、摘要、意图、理由、适用条件、关键动作和陷阱。
图中要点:每一组变成一条带有上述字段的配方;具体程度随层次升高而降低,从写出 API 名称到完全通用的原则。
2环节 2 · 按阶段检索并生成计划

所有粒度同一个候选池,每个阶段一份计划。

对新 issue u 和每个阶段 s,所选历史修复中阶段 s 的每条配方都是候选,不论粒度。STAIR 按与 issue 报告的余弦相似度(Qwen3-Embedding-8B)把它们排进同一个列表,再由 LLM 验证器剔除在该阶段不适用的配方。保留下来的集合 Rs(u) 可以混合不同粒度和不同来源 issue。随后由 LLM 写出阶段计划 Ps(u) = Plan(u, Rs(u)):保留适用的指导,去掉无关或相互冲突的部分,并把互补的配方组合成针对该 issue 的动作序列。

新 issue · 只用报告

Make the form edit-only, no new entries allowed

  1. 把阶段 s 所有粒度的配方排进同一个列表
  2. LLM 验证器剔除在该阶段不适用的配方
  3. 保持顺序:同一轨迹的配方按执行顺序排列,宽泛的排在具体的之前
检索到的配方 Rs(u)
#1 Issue A高层Always enforce intent at every system layer, …
#2 Issue A中层When a feature is blocked via UI, also check …
#3 Issue B中层Check whether hidden pages still allow POST …
生成的计划 Ps(u)
  1. Find out how the form controls user actions
  2. Add a proper “edit-only” setting from #2
  3. Block new entries everywhere, not just on screen from #1, #3
  4. …

示例来自论文图 1。检索只使用 issue 报告;计划中与仓库相关的细节,由修复智能体在探索目标代码库时核对和调整。

3环节 3 · 计划引导的 issue 解决

计划引导智能体,决定仍由智能体做出。

每份计划在对应阶段交给修复智能体。智能体仍会探索仓库、修改代码、运行检查并响应测试反馈;当新证据与计划冲突时,它可以修正自己的决定。底层智能体仍负责构造并验证最终的补丁。

阶段 1

定位

Ploc(u)

引导智能体关注相关的失败证据和候选代码位置。

阶段 2

规划

Pplan(u)

描述预期的修改策略、修复范围和相关约束。

阶段 3

执行与验证

Pexec(u)

建议实施修复以及检查修复的步骤。

主要脚手架 · RQ1、RQ3、RQ4

Lingxi

保留其决策逻辑、工具和三阶段修复流程;关闭原有的知识复用机制,每个阶段的 prompt 中加入该阶段的 STAIR 计划。

迁移目标 · RQ2

mini-SWE-agent v2

一个只使用 bash 的极简智能体。计划以 <external_reference_plans> 块的形式加在输入前面;其源代码、工具定义和验证逻辑保持不变。

03 · 评估

多粒度复用是否有效?

所有实验都在 SWE-bench Verified 上进行:来自 12 个 Python 仓库的 500 个真实 GitHub issue,每个都由开发者编写的测试检验。Pass@1 是单次智能体运行的最终补丁所解决的 issue 比例。实验使用两个基座模型,均开启高推理强度(HR):GPT-5(商用)和 MiniMax M2.5(开放权重)。对每个目标 issue,历史 issue 来自同一仓库、创建时间早于它,并且与评估实例不重叠。

配方:用 GPT-5 一次性构建每个实例 10–15 分钟$0.84 / 实例 · MiniMax M2.5$1.60 / 实例 · GPT-5
RQ1 · 与修复智能体对比

同一脚手架、同一模型:Pass@1 更高。

GPT-5 (HR)同一基座模型
live-SWE-agent
68.4
OpenHands
71.8
Lingxi同一脚手架,原有知识复用机制
75.6
STAIRLingxi 脚手架 + 修复配方
+3.6 pp79.2
MiniMax M2.5 (HR)同一基座模型
Lingxi同一脚手架,原有知识复用机制
74.6
mini-SWE-agent v2
75.8
STAIRLingxi 脚手架 + 修复配方
+6.6 pp81.2
Claude 4 Sonnet论文报告的结果 · 基座模型不同 · 未运行 STAIR
SWE-Exp
73.0
ExpeRepair以 o4-mini 作为后备模型
74.6
Lingxi
74.6
Pass@1 (%) · 坐标轴从 65 开始
6570758085
+6.6 ppMiniMax M2.5 · Lingxi → STAIR74.6 → 81.2,只改变知识复用机制
+3.6 ppGPT-5 · Lingxi → STAIR75.6 → 79.2,只改变知识复用机制

怎么读各行按基座模型分组,因此组内只有智能体不同;论文表 2 按智能体类型列出同样的数字。深灰色的 Lingxi 是受控对比:脚手架、基座模型、工具和历史 issue 都相同,只是用其原有的知识复用机制代替 STAIR 的配方和计划。Claude 4 Sonnet 一组是基座模型不同的报告结果,这组比较的受控程度较低。

图中要点STAIR 在 MiniMax M2.5 上达到 81.2%,在 GPT-5 上达到 79.2%,在论文报告的设置下高于所有对比的智能体。只改变知识复用机制,在 MiniMax M2.5 上提升 6.6 个百分点,在 GPT-5 上提升 3.6 个百分点;GPT-5 下 Lingxi 的基线更高,提升空间可能更小。在相同的基座模型下,STAIR 比 OpenHands 高 7.4 个百分点,比 live-SWE-agent 高 10.8 个百分点,比 mini-SWE-agent v2 高 5.4 个百分点。

RQ2 · 迁移到另一个智能体 · MiniMax M2.5

计划也能引导另一个智能体。

500 个 issue 上的 Pass@1

解决数

mini-SWE-agent v2379/500 · 75.8%
+ STAIR 计划405/500 · 81.0%
+5.2 pp · 解决数 379 → 405
每个实例

平均步数

mini-SWE-agent v260.45
+ STAIR 计划58.18
步数减少 · 60.45 → 58.18
每个实例的总量

平均 token 数

mini-SWE-agent v21,244,923
+ STAIR 计划1,179,885
−5.2% · 1,245k → 1,180k

怎么读mini-SWE-agent v2 有自己的架构、工具接口和提示策略。唯一的改动是在输入前加上 STAIR 计划块,这些计划由基于 Lingxi 轨迹构建的配方生成。数据来自论文表 3,覆盖全部 500 个实例。

图中要点Pass@1 从 75.8% 升到 81.0%(+5.2 个百分点),接近 STAIR 在 Lingxi 脚手架上的结果(81.2%)。平均步数从 60.45 降到 58.18,每个实例的 token 用量减少 5.2%:计划并不只是增加上下文,智能体的探索也减少了。这是对另一个脚手架的证据,并不说明适用于所有智能体脚手架。

RQ3 · 计划如何改变智能体行为

计划在哪里有用,又在哪里不足。

新增解决与退化的实例 · 表 4
STAIRMiniMax vs. LingxiMiniMax共同解决 363 个
+33净增
mini-SWE-agent v2 + Plans vs. 原版共同解决 372 个
+26净增
新增解决的原因 · 计划纠正了什么 · 图 4(重绘)

Wrong Location · 定位错误

基线修改了错误的组件,且无法从这一早期错误中恢复;计划从一开始就把智能体引向正确位置,例如修复上游的序列化器,而不是下游的加载器。

12 (28%)
17 (52%)

Partial Fix · 修复不完整

基线找到了根因,却只修改了部分受影响的代码。在 django-11138 中,它修复了 MySQL 和 Oracle 的时区转换问题,漏掉了 SQLite;计划把它定义为一次跨后端排查。

21 (49%)
10 (30%)

Over-modification · 过度修改

基线改动的代码多于必要;计划把修复限制在最小改动内,例如扩展一个匹配条件,而不是重写整个发现流程。

10 (23%)
6 (18%)
退化的原因 · 全部 17 个退化
8 · 与计划有关

计划遗漏了部分修改范围

计划把握住了主要方向,但没有覆盖所有改动;通常是修复需要在多个文件或入口点上协同修改。其中 5 个来自 STAIRMiniMax,3 个来自 mini-SWE-agent v2 + Plans。

9 · 与计划无关

计划合适,执行失败

智能体偏离计划、做了不必要的复杂修改,或者犯了局部错误,例如用错 API 或传错参数。其中 5 个来自 STAIRMiniMax,4 个来自 mini-SWE-agent v2 + Plans。

怎么读“新增解决”指只有加入 STAIR 计划后才解决的实例;“退化”指只有基线解决的实例(STAIR 的基线是 Lingxi,加计划版本的基线是原版 mini-SWE-agent v2)。两位作者根据每个实例的计划、补丁和完整轨迹分别标注,再讨论分歧达成一致(Cohen's κ = 0.85)。

图中要点新增解决多于退化:43 比 10,33 比 7。每个智能体都在自己最薄弱的地方获益:Lingxi 已有显式的定位阶段,所以计划主要是扩大修复范围(Partial Fix,49%);只用 bash 的 mini-SWE-agent v2 最常从错误的位置入手,所以计划主要是把它引到正确位置(Wrong Location,52%)。在 17 个退化中,8 个源于计划遗漏了部分所需范围;其余 9 个是计划合适但执行失败。

RQ4 · 消融实验 · 125 个实例的子集 · MiniMax M2.5

没有哪个单一粒度比得上完整候选池。

多粒度复用完整系统 · 全部粒度
100/125 · 80.0
仅低层单一粒度
80/125 · 64.0−16.0
仅中层单一粒度
76/125 · 60.8−19.2
仅高层单一粒度
73/125 · 58.4−21.6
原始轨迹不做抽象
72/125 · 57.6−22.4
91.4%完整系统中的阶段计划使用了不止一种粒度的配方
−22.4 pp用原始轨迹代替配方各变体中下降最多

怎么读每个变体只改变复用的内容。这 125 个实例按难度分层抽样:92 个(73.6%)为中等或困难,估计修复时间至少 15 分钟;33 个(26.4%)为简单。该子集侧重较难的 issue,因此在完整基准上的差异可能不同。

图中要点完整候选池解决了 125 个中的 100 个(80.0%)。只从单一粒度检索会损失 16.0 到 21.6 个百分点;三者中低层配方最好,可能因为它们更可直接执行,但仍落后 16.0 个百分点。复用原始轨迹的结果最低,为 57.6%。这些结果支持把配方保留为多个粒度,并针对每个 issue 和阶段从中选择。
04 · 有效性威胁

这些结果不能说明什么。

以下局限均由论文本身指出,上面的数字应在这些范围内理解。

外部

一个基准,一种语言

SWE-bench Verified 包含来自 12 个仓库的 500 个 Python 实例。结论未必适用于其他语言、基准或私有代码库。

外部

一个来源智能体,一个迁移目标

配方来自 Lingxi 的轨迹,换一个来源智能体,轨迹质量可能不同。RQ2 显示计划可以迁移到 mini-SWE-agent v2,但不代表其他脚手架。

内部

LLM 构建的配方,人工标注

分组、抽象和相关性验证器都基于 LLM;配方质量可能随轨迹长度变化,验证器也可能丢掉有用的配方或保留不适用的配方。RQ3 的标注涉及主观判断(κ = 0.85)。

构念

测试、两个模型、抽样消融

Pass@1 依赖已有的测试,可能接受行为上不正确的补丁。两个基座模型不能说明其他模型也有同样收益。RQ4 使用的子集偏向较难的 issue。

05 · 引用

BibTeX

请引用 arXiv 预印本。

@misc{xu2026reusingpastrepairshierarchical,
  title         = {Reusing Past Repairs Through Hierarchical Trajectory
                   Abstraction for Coding Agents},
  author        = {Yisen Xu and Jiayuan Zhou and Ruiqi Pan and Tse-Hsun Chen},
  year          = {2026},
  eprint        = {2607.29658},
  archivePrefix = {arXiv},
  primaryClass  = {cs.SE},
  url           = {https://arxiv.org/abs/2607.29658}
}